---
title: "PDFからHTMLを抽出する"
slug: "extract-html-from-a-pdf"
abstract: "Sitecore Searchで一時的なソースを設定し、PDF文書のHTML構造を表示できます。"
---
# PDFからHTMLを抽出する
Sitecore Search[ドキュメントエクストラクタ](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/additional-configurations-and-settings/configuring-document-extractors.html "Configuring document extractors") はHTMLしか解析できません。そのため、*タイトル*、*説明*、*タグ*などの属性を正確に抽出するために、PDFのHTML構造がどのようなものかを知る必要があります。
これを行うには、PDFのHTML構造を明らかにするだけの目的を持つ一時的なソースを設定してください。このソースでJavaScriptドキュメントエクストラクタを選択し、html() jQueryメソッドを使って*PDF全体* からHTMLを抽出します。その後、Content CollectionでPDFのHTML構造を確認した後、個々の属性をどのように抽出するかを最適に判断できます。
このウォークスルーでは、以下の方法を説明します:
:::攻略
1. [HTML抽出を可能にするダミー属性を作成します](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/configure-indexing/configure-for-pdfs/extract-html-from-a-pdf.html#create-a-dummy-attribute-to-enable-html-extraction)
2. [一時的な高度なウェブクローラーソースを作成し、トリガーを設定してください](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/configure-indexing/configure-for-pdfs/extract-html-from-a-pdf.html#create-a-temporary-advanced-web-crawler-source-and-configure-triggers)
3. [HTMLを抽出するためにJavaScriptドキュメントエクストラクタを設定しましょう](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/configure-indexing/configure-for-pdfs/extract-html-from-a-pdf.html#configure-a-javascript-document-extractor-to-extract-html)
4. [View Content CollectionのPDFのHTML構造](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/configure-indexing/configure-for-pdfs/extract-html-from-a-pdf.html#view-the-html-structure-of-the-pdf-in-the-content-collection):::
> !注**始める前に**
>
> - 持っているPDFコンテンツの種類を表すURLをいくつか集めましょう。
>
> - PDFをスキャンしてパターンを探しましょう。例えば、表が多いテキストが多いもの、テキストが限られた画像が多いもの、質問と回答のリストのものなどに気づくかもしれません。各グループから1 PDF URLをメモすれば、3つの代表的なPDFが得られます。
>
> - 代表的なPDFを特定しましょう。後で *すべての*PDFを抽出するソースを設定する際には、サンプルPDFのHTML構造に基づいてドキュメントエクストラクタを作成します。
>
## HTML抽出を可能にするダミー属性を作成します
PDFドキュメント全体をHTML形式で抽出するための属性が必要です。混乱を避けるために、この目的専用の属性を作成することをお勧めします。
HTML抽出を可能にするダミー属性を作成するには:
[以下の詳細を含む属性を作成・公開します:](https://doc.sitecore.com/search/ja/users/search-user-guide/configure-entities/add-an-attribute.html "Add an attribute")
- **エンティティ**: **Content**。
- **表示名**: *PDFからHTMLへ*、または類似の形式。
- **Attribute 名前**: *pdf\_to\_html*、または類似の名称。
- **配置**:**標準。**
- **データ型**: **文字列**。
## 一時的な高度なウェブクローラーソースを作成し、トリガーを設定してください
PDF内容を表すPDFだけをクロールできる [高度なウェブクローラー](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/configure-indexing/configure-an-advanced-web-crawler.html "Configure an advanced web crawler") を作成します。必要な [トリガー](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/additional-configurations-and-settings/configure-triggers.html "Configure triggers") は、開始前に特定したPDFのURLだけです。
一時的な高度なウェブクローラーソースを作成し、トリガーを設定するには:
1. **CONNECTOR**タイプの**ウェブクローラー(上級版)**でソースを作成します。目的を明確にするためにソース名を明示してください。例えば*、PDFからHTMLへの変換*などです。
2. **前提条件で指定したPDFのURL**[でリクエストトリガーを作成してください。その他の設定はデフォルトのままにしてください。](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/additional-configurations-and-settings/configure-triggers/create-a-request-trigger.html "Create a request trigger")
3. 他のPDF URLについてもステップ2を繰り返します。例えば、3つのサンプルPDFを特定し、それぞれに異なるパターンがある場合、 *Request* トリガーは3つあります。
4. ハイパーリンクされたURLのインデックスをクローラーで止めるには、**最大深度****\> Settingsクローラー**をクリックし、値を*0*に変更してください。
## HTMLを抽出するためにJavaScriptドキュメントエクストラクタを設定しましょう
[ドキュメント抽出器は](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/additional-configurations-and-settings/configuring-document-extractors.html "Configuring document extractors") 元のコンテンツから [インデックス文書](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/configure-indexing/configure-for-pdfs/index-items.html#UUID-4a95bc8e-f38d-f31d-8e98-9d2f7b400234_section-idm4581825664620833496946254764 "Index documents") を作成します。各インデックスドキュメントには属性と属性値があります。この例では、*pdf\_to\_html*属性の値だけを気にします。PDFのHTML構造を抽出するには、html() メソッドを使って*pdf\_to\_html*属性の値を抽出するJavaScriptドキュメントエクストラクタを設定してください。
JavaScriptドキュメントエクストラクタをHTML抽出するために設定するには:
1. [以下の機能を使用するJavaScriptドキュメントエクストラクタを作成します:](https://doc.sitecore.com/search/ja/users/search-user-guide/index-items/additional-configurations-and-settings/configuring-document-extractors/create-a-javascript-document-extractor.html "Create a JavaScript document extractor")
// Sample document extractor function to get HTML from PDF content.
function extract(request, response) {
$ = response.body;
return {
'pdf\_to\_html': $('html').html(), // gets the HTML structure of the document's root element and assigns it to the pdf\_to\_HTML attribute
'type': "pdf" //Mandatory attribute. Uses the fixed value of 'pdf'
};
}
2. [公開](urn:resource:component:1033035) してソースをスキャンしてください。
## ViewはPDFのHTML構造をContent Collectionでご覧ください
Content Collectionを使ってインデックスされた文書を見つけ、*pdf\_to\_html*属性で抽出された内容を確認できます。
Content **Collection**でHTML版のPDFを見るには:
1. Click **Content Collection**。
2. **Sources**でフィルターを選び、一時的な高度なウェブクローラーを作成した際に作成したソースを選択してください。
インデックスしたPDFを表すcontent itemsのリストが表示されます。
3. Click a content item。
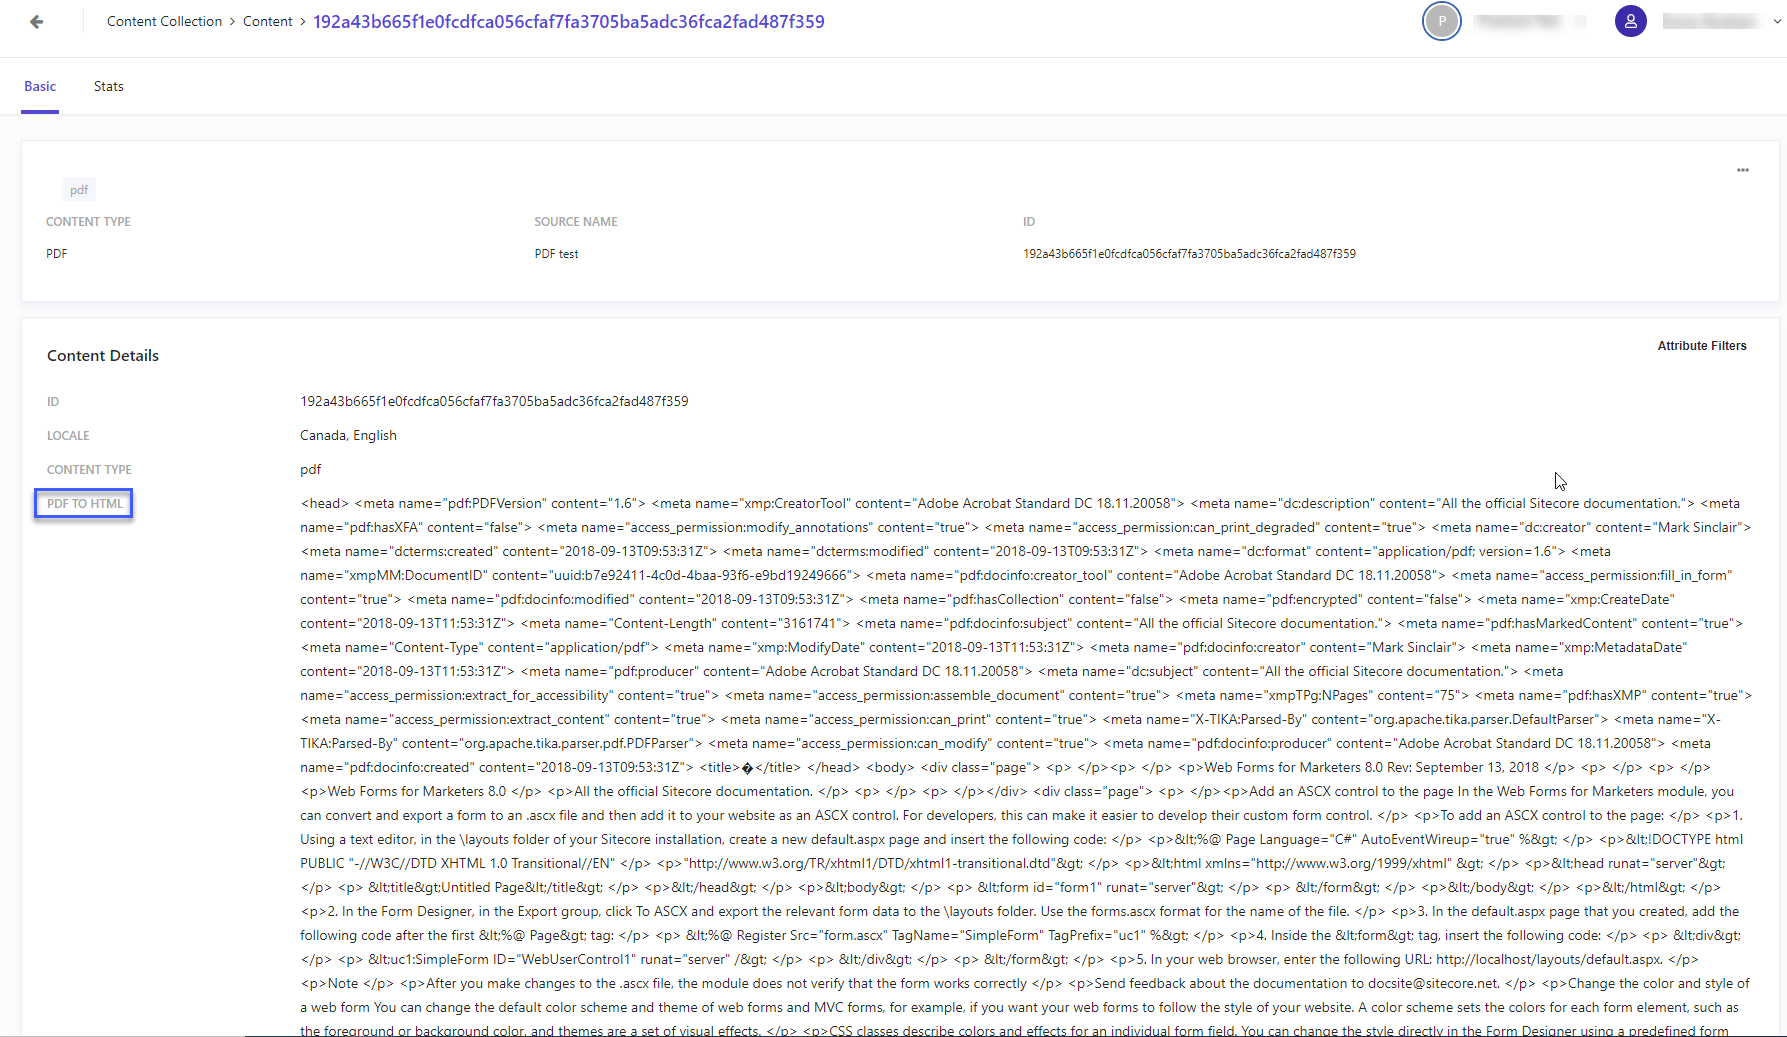
4. **Content Details**のセクションで、「**PDF to HTML**」属性を探してください。この属性の値はPDFのHTML構造です。
5. すべてのcontent itemsについて、ステップ4と5を繰り返します。
PDFのHTML構造がどのようなものかを確認したので、この情報を活用して正確なドキュメントエクストラクターを作成してPDFコンテンツを抽出できます。