コンテナDR基本コールドスタンバイ
このページの翻訳はAIによって自動的に行われました。可能な限り正確な翻訳を心掛けていますが、原文と異なる表現や解釈が含まれる場合があります。正確で公式な情報については、必ず英語の原文をご参照ください。
Sitecore DR Basic Cold Standbyを用いることで、Sitecore Managed Cloud災害復旧サービスは障害発生時にプロセスを開始します。プライマリリージョンで障害が発生した場合、セカンダリデータセンターに新しいSitecore本番環境が作成されます。セカンダリ環境の作成中は、サイトが一時的にダウンしていることを顧客に知らせる簡単な障害ページが表示されます。新しい環境はセカンダリデータセンターで作成する必要があるため、この復旧オプションはRTOが長くなりますが、コストは安価です。
以下の図はDR Basicセットアップ前のコンテナのインフラストラクチャを示しています。
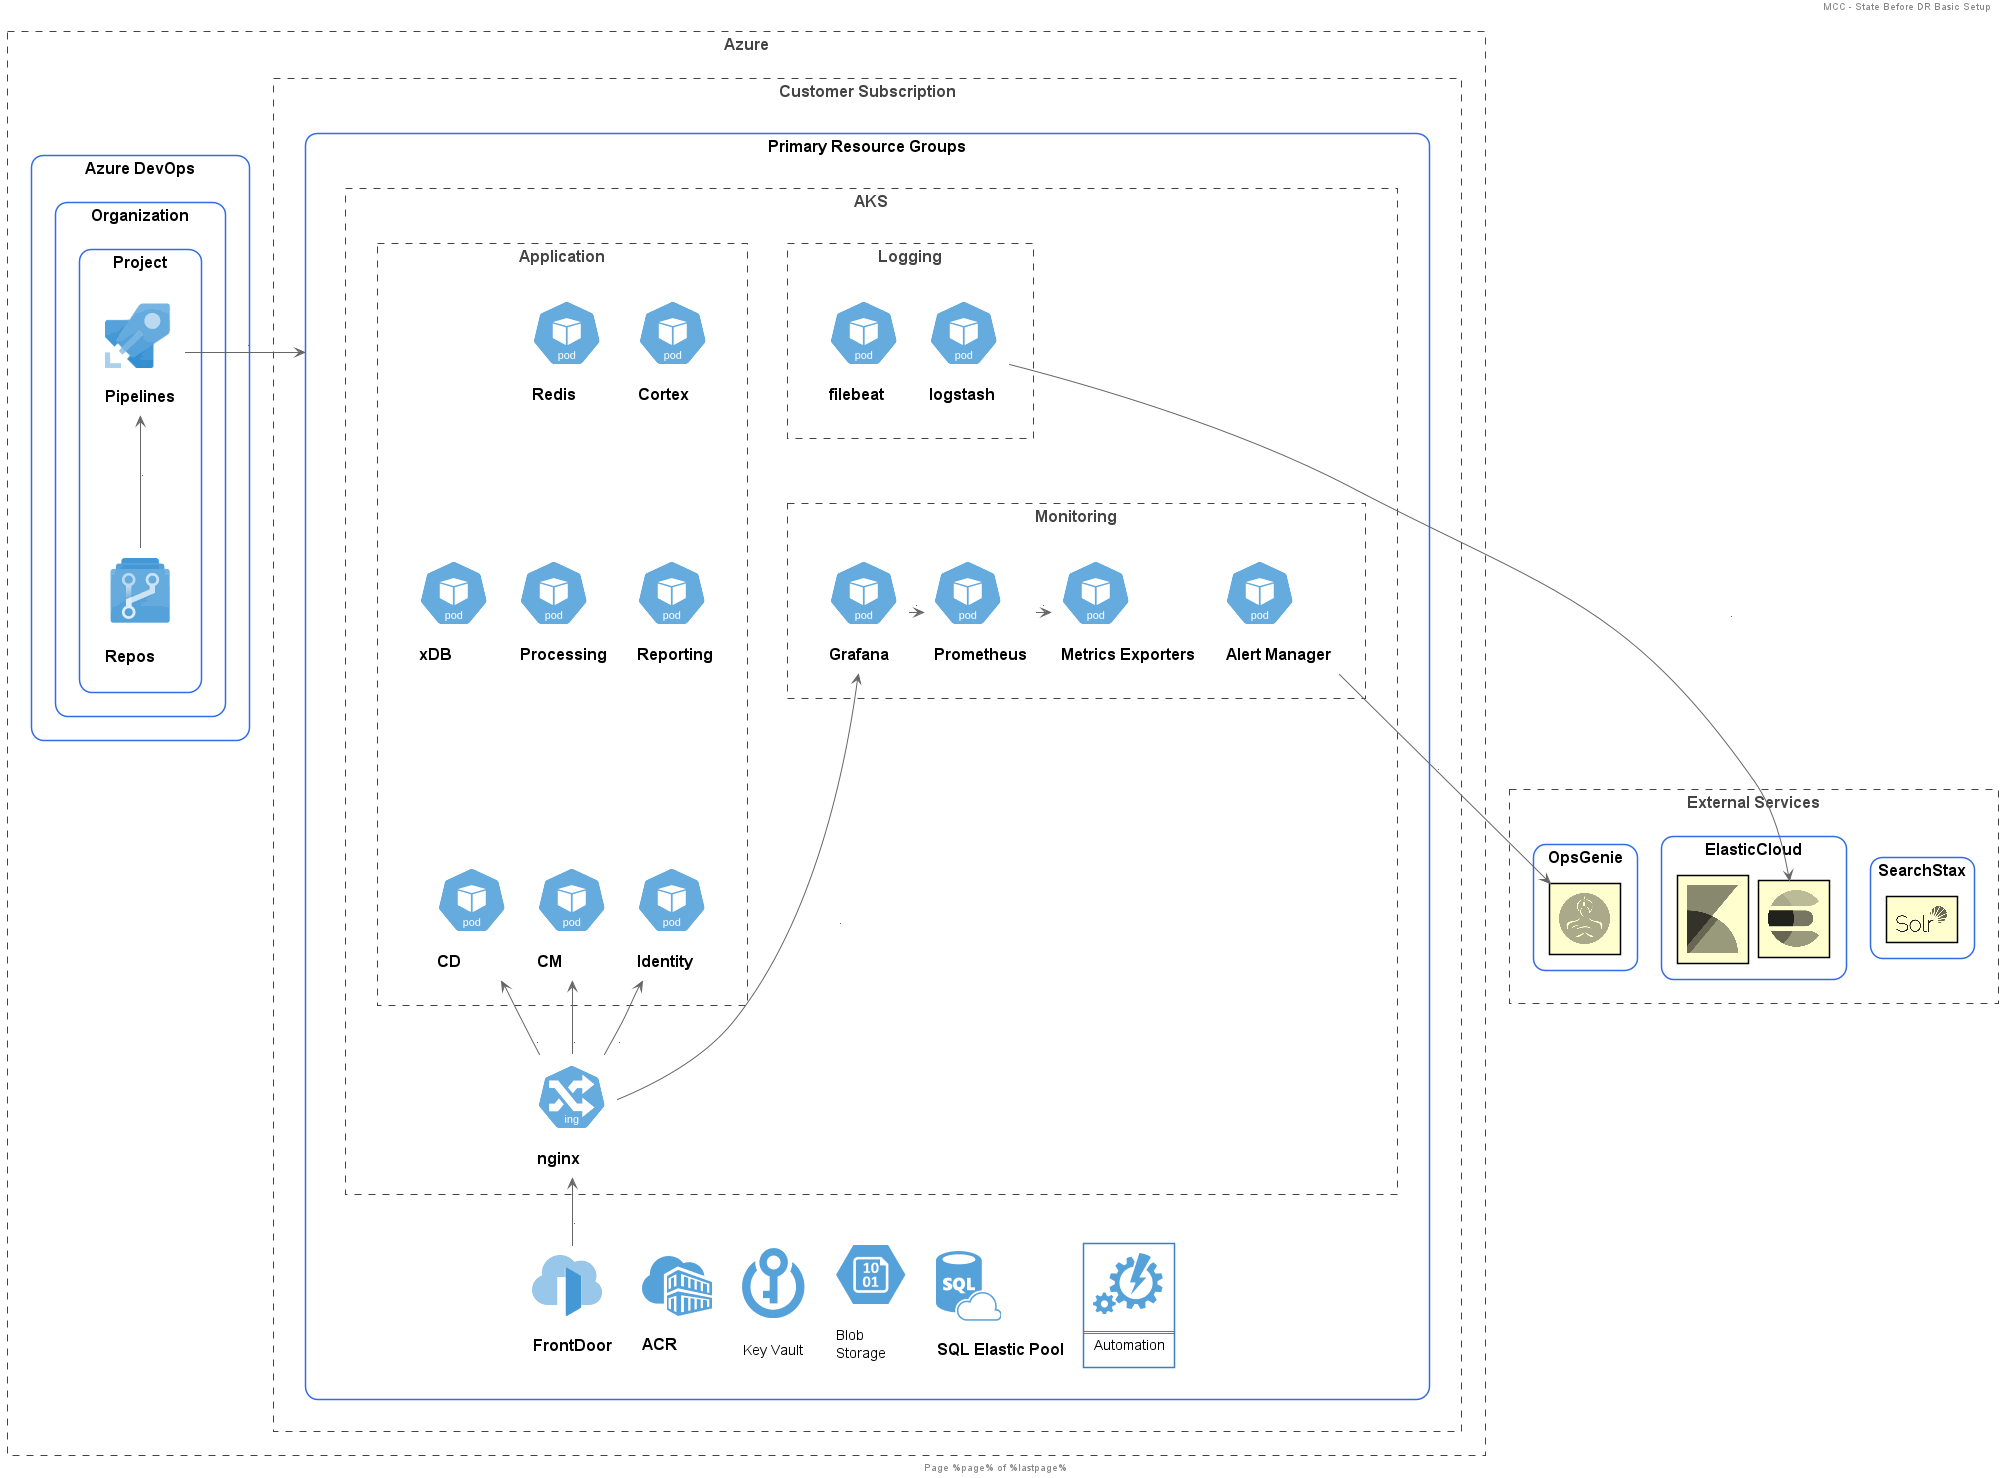
セットアップ
セットアップ手順は以下の通りです:
- 制御リソースグループおよびDR状態を監視する関連する基盤リソースやサービスをプロビジョニングします。
- Configure Azure FrontDoor.
- SQLサーバー、ACR、ストレージアカウントのジオレプリケーションを設定してください。
- SQLジオレプリケーション用のエンドポイントを認識するために、アプリケーションリポジトリを更新してください。
以下の図は、DR Basicセットアップを行った後のコンテナのインフラストラクチャ状態を示しています。
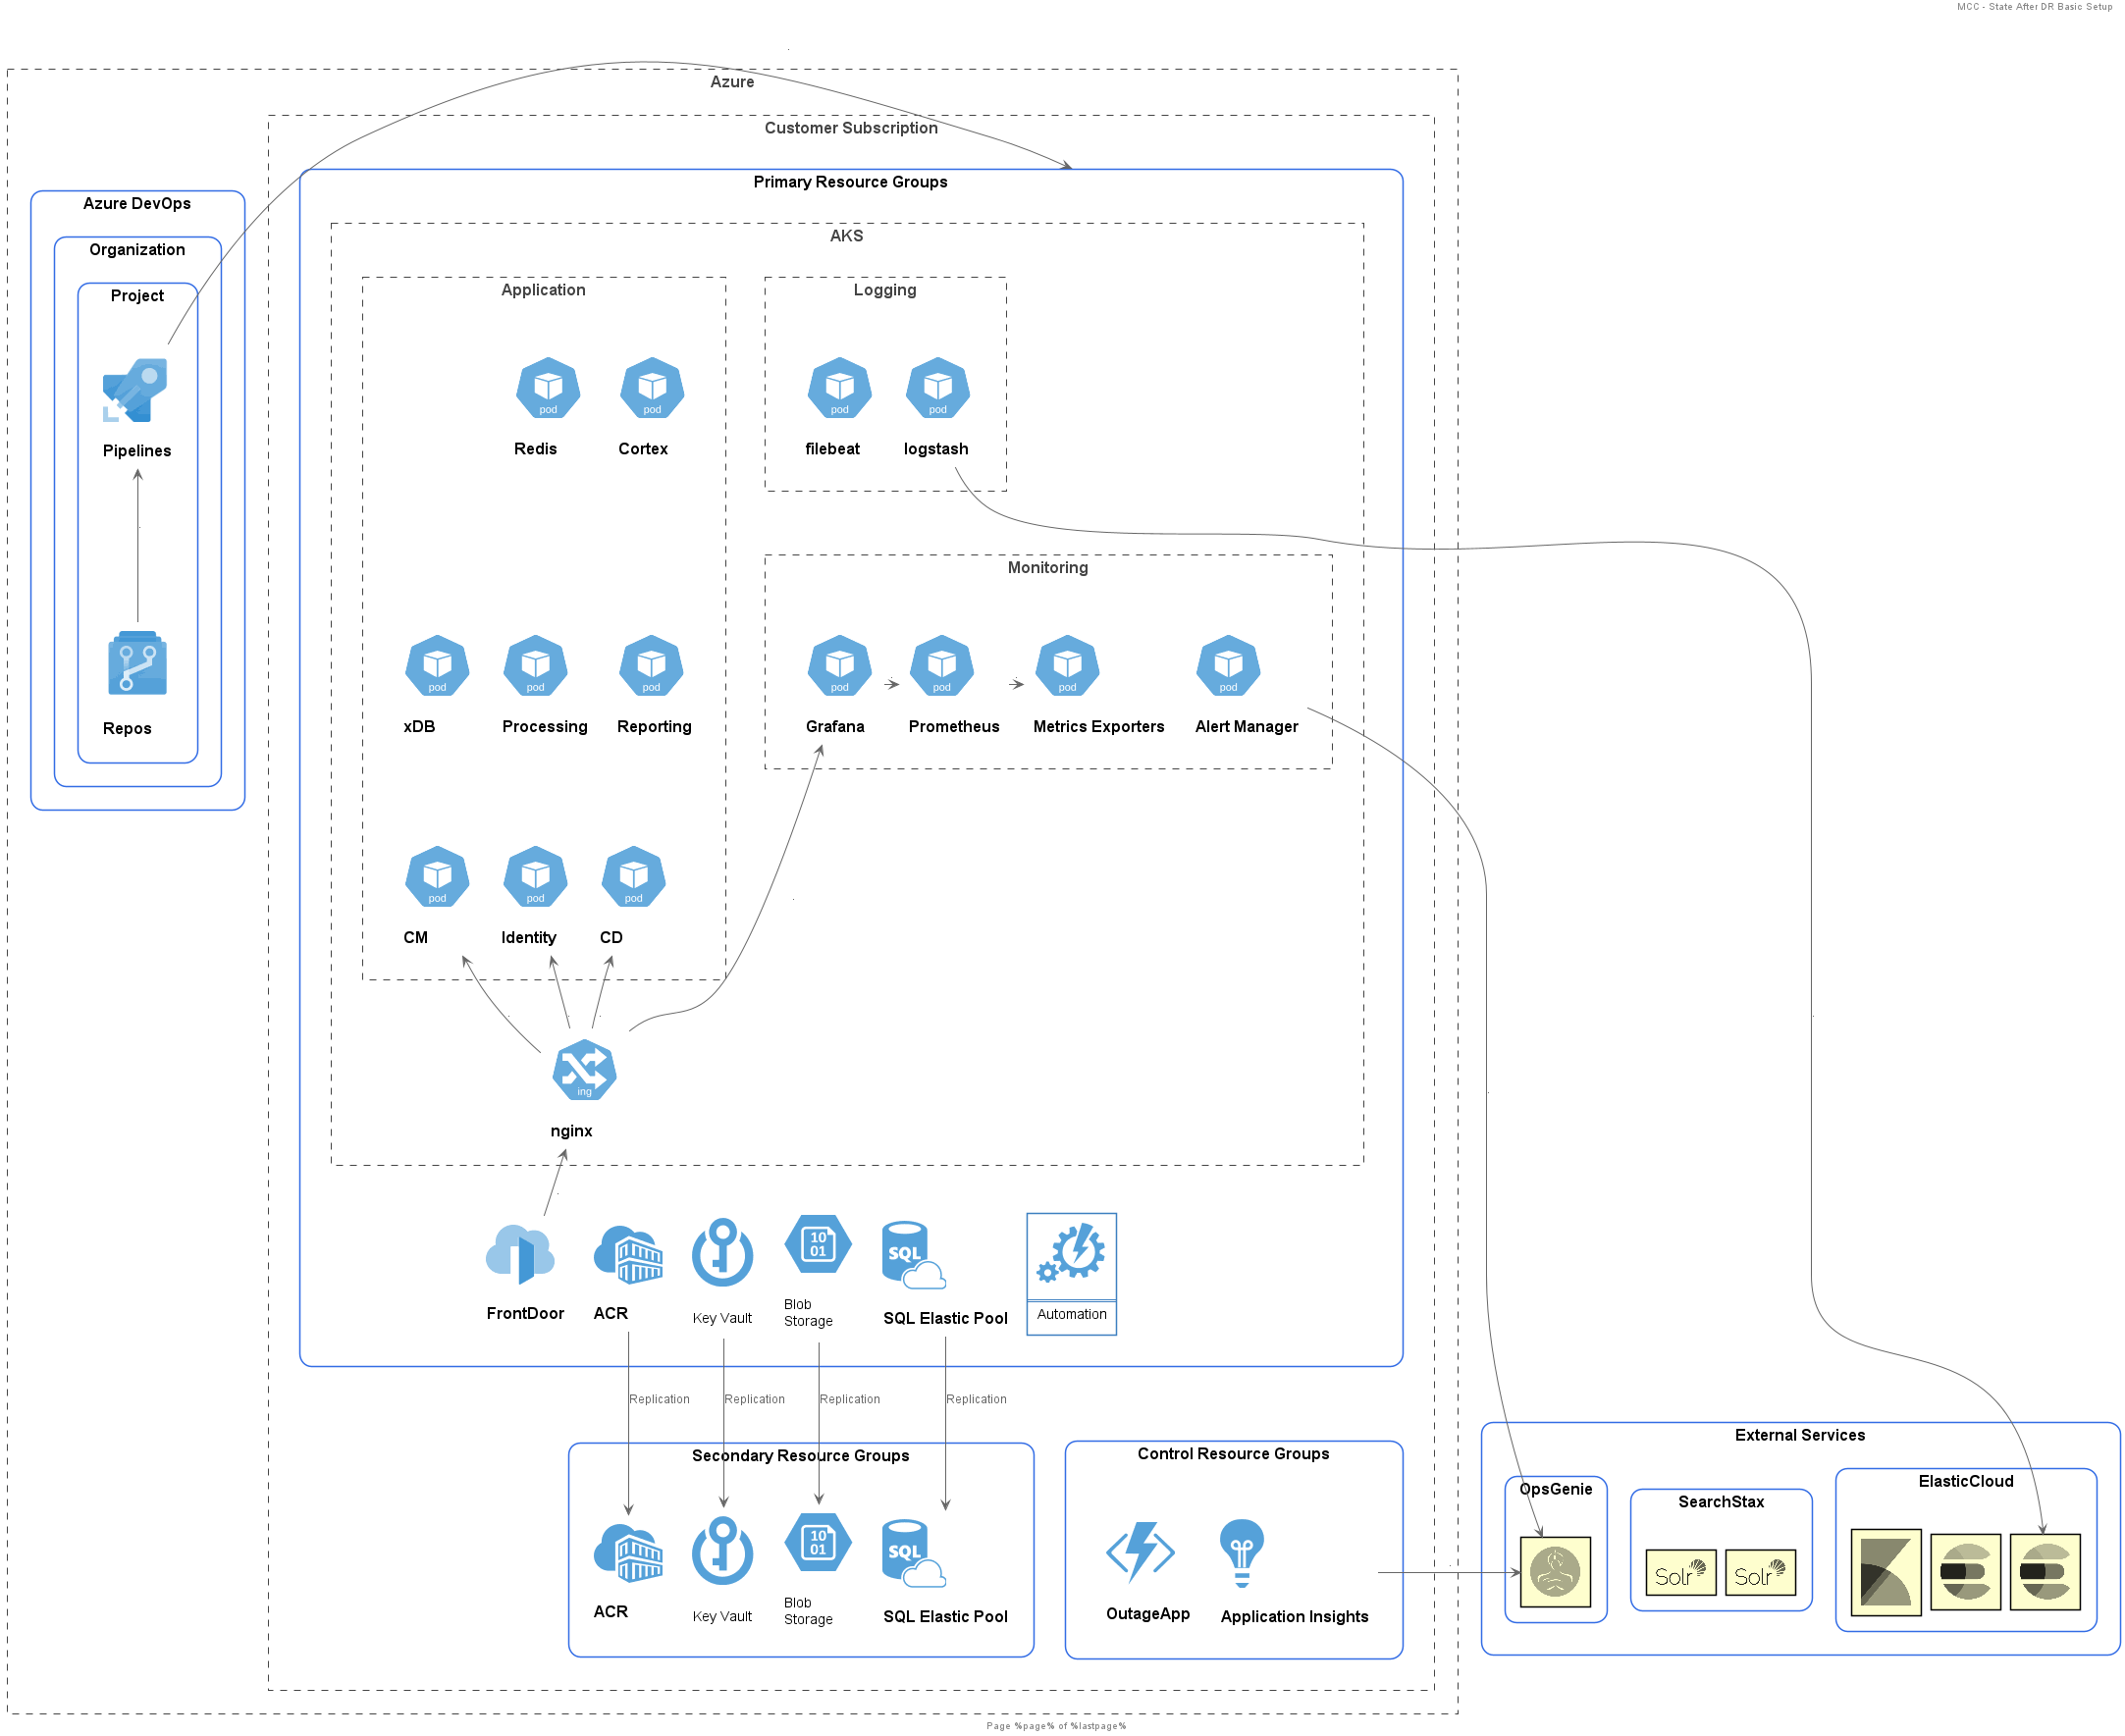
!注Sitecoreは顧客がサービスリクエストを開始した後にセットアップを実行します。
フェイルオーバーの開始
Sitecore Managed Cloudプライマリージョン環境の健康状態を継続的にチェックします。5つのデータセンターのうち3つが問題を報告した場合、Sitecore Managed Cloud運用チームはプライマリデータセンターのSitecore環境を調査し、正当な問題か誤検知かを確認します。運用チームはプライマリーデータセンターで以下の検証チェックを行います:
- Sitecoreサイトで使用されているAzureリソースによるアラートを確認しましょう。
- トラフィックマネージャーが劣化したエンドポイントを報告しているか確認してください。
- 既知のデータセンターの問題については Azureステータスサイト を確認してください。
クラウドオペレーションチームがプライマリデータセンターの基盤インフラの一部または全部に回復不能な問題があると判断した場合、フェイルオーバー確認プロセスが開始され、顧客に連絡が行われます。
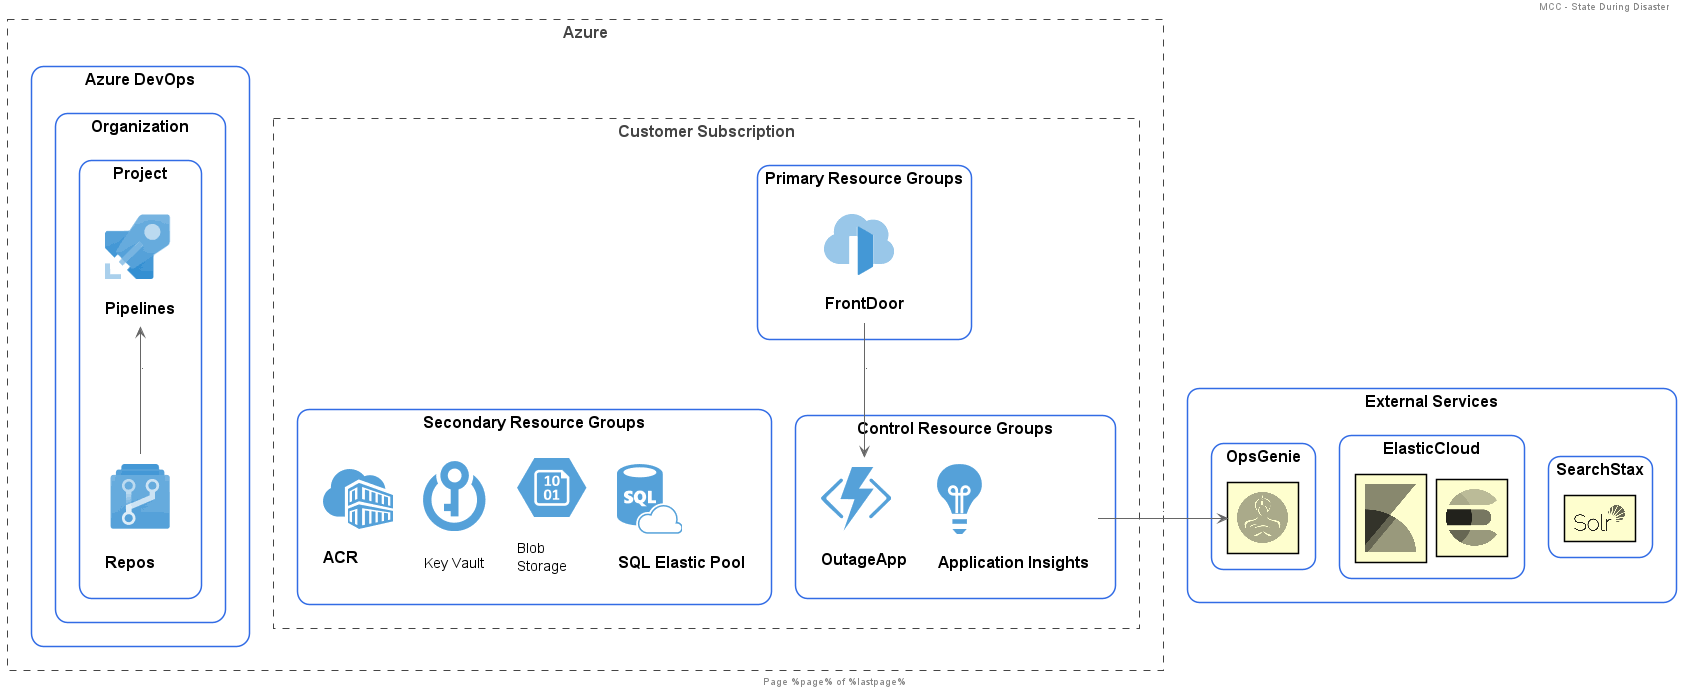
災害時には主要なリソースが利用できず、Azure FrontDoorはユーザーに障害ページを提供します。以下の画像は災害時の状態を示しています。
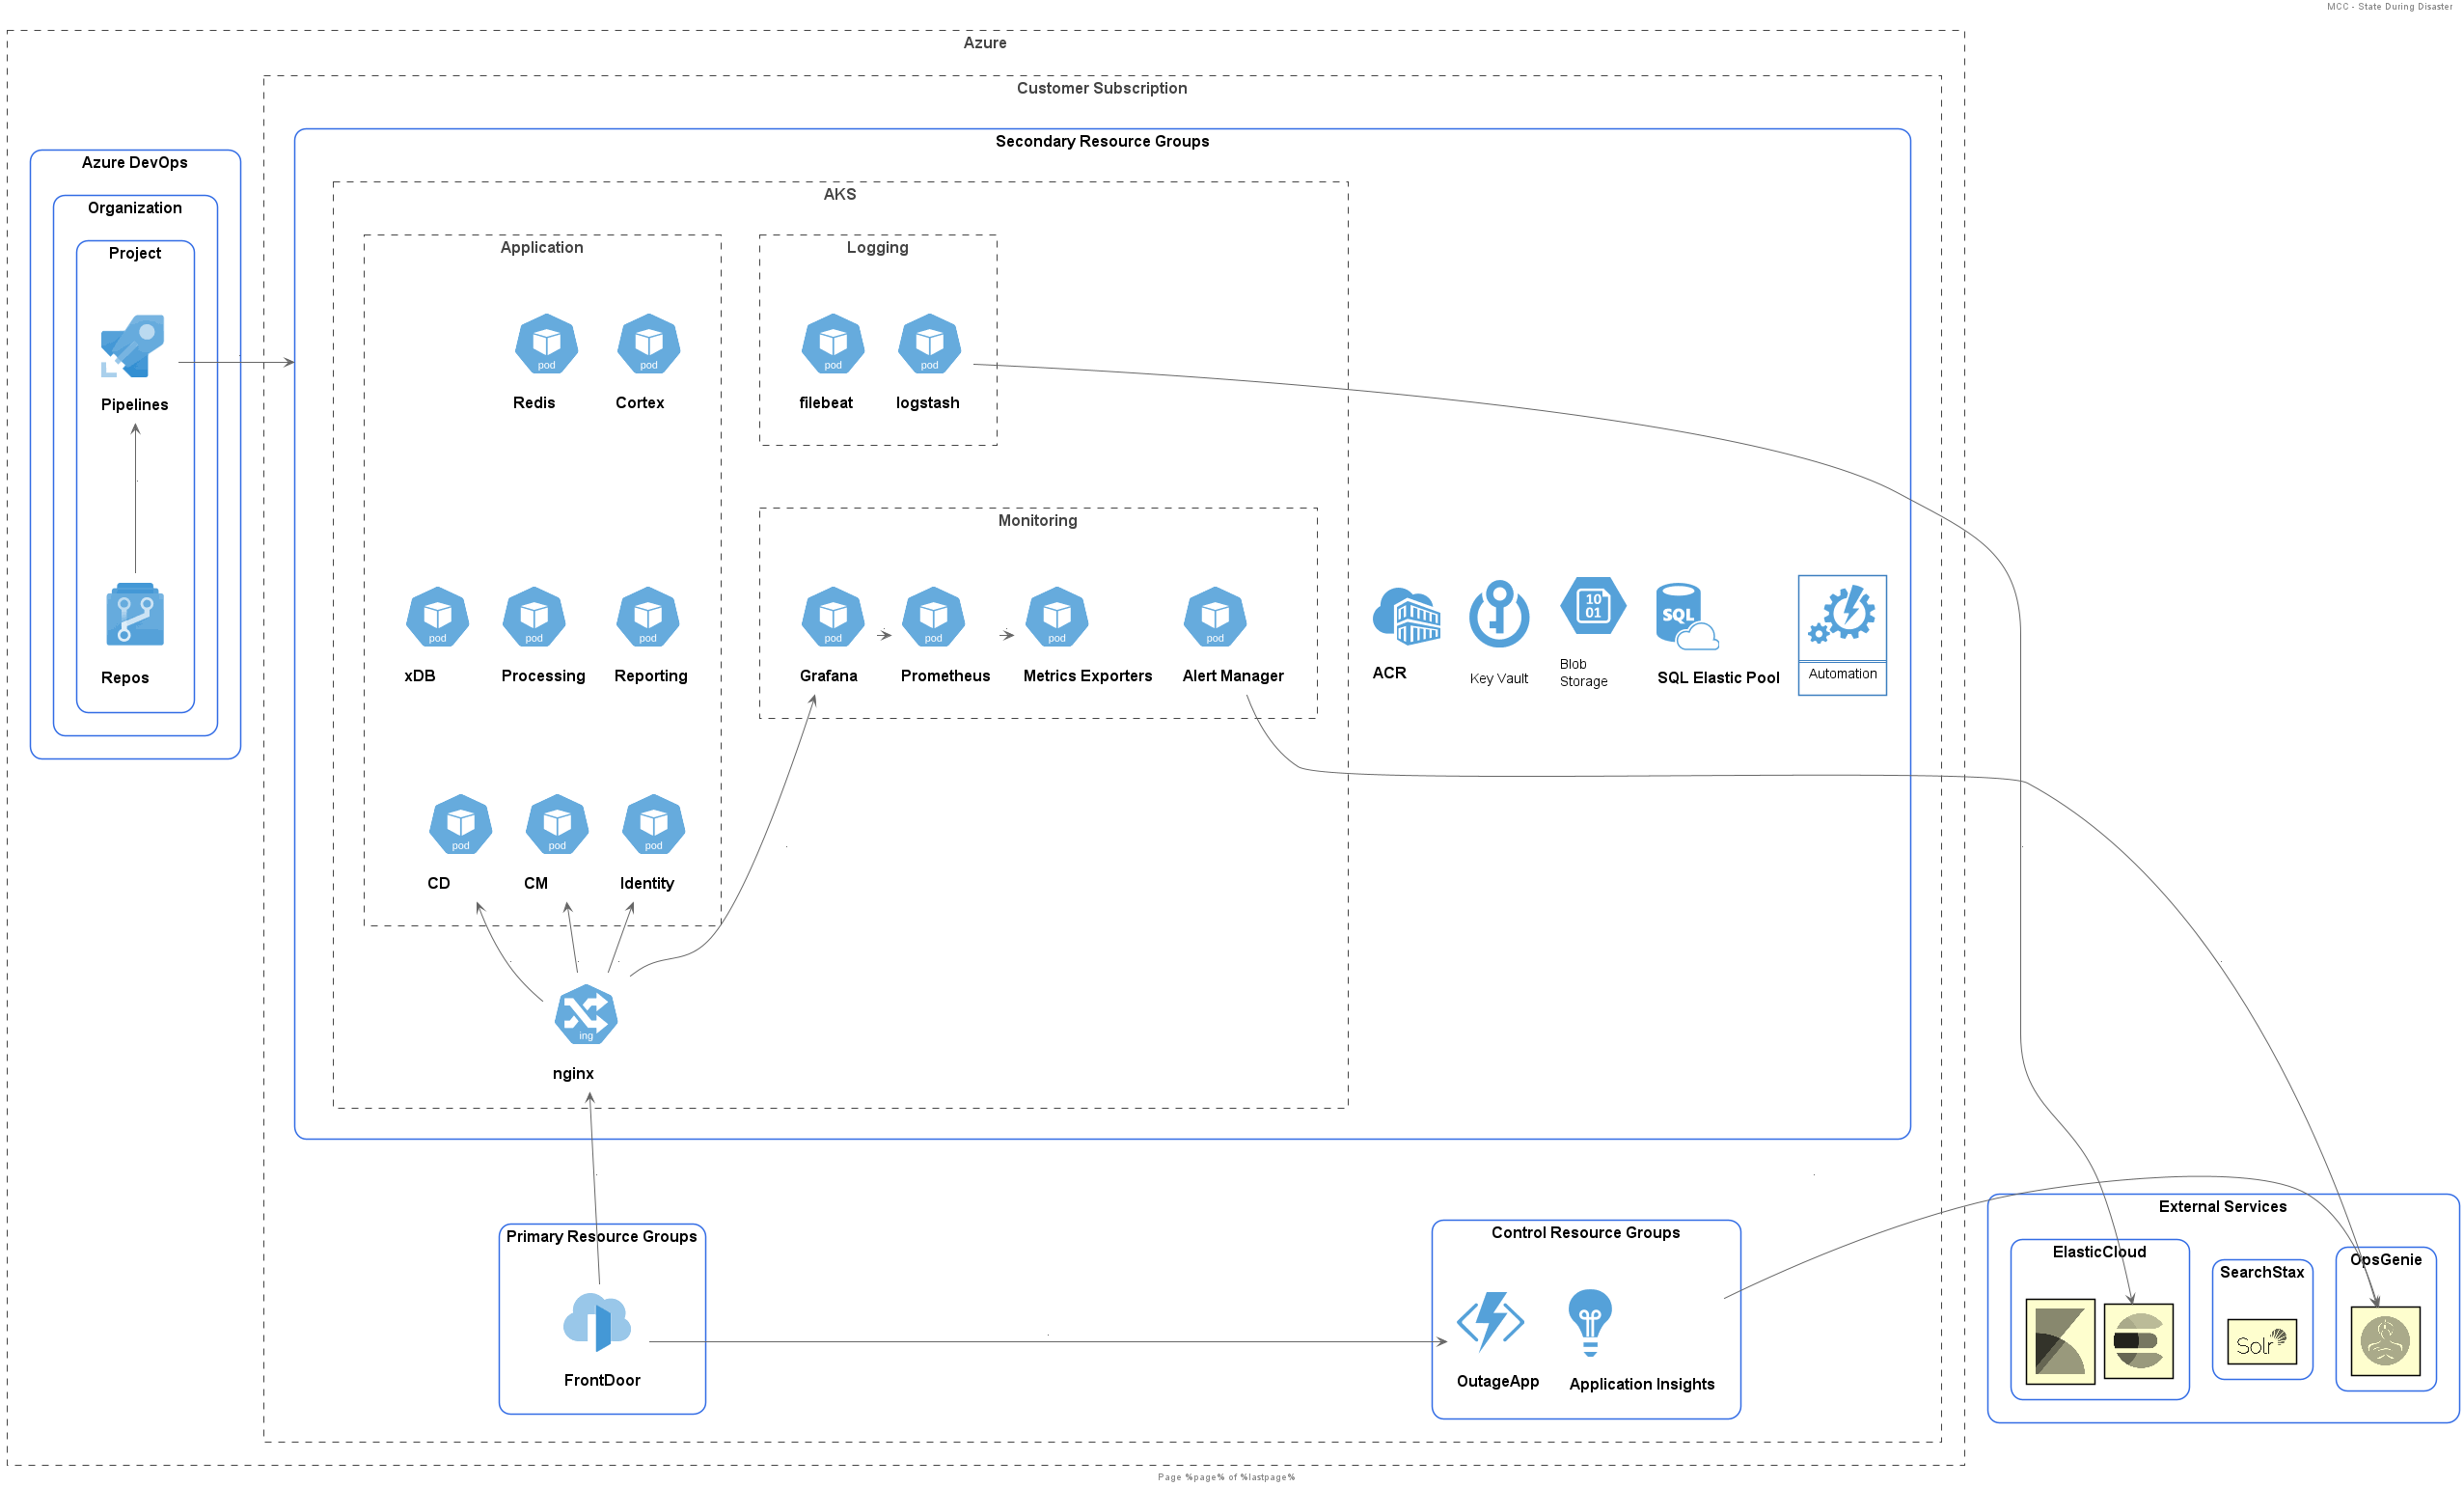
以下の画像は、DR Basicフェイルオーバーを実行した後のコンテナのインフラストラクチャを示しています。
フェイルオーバー/リカバリー確認
顧客が確認すると、Sitecoreは以下の手順で回復手続きを開始します。
- インフラのプロビジョニングは二次的なもの。
- セカンダリでのアプリケーションプロビジョニング。
- AFDを切り替えてトラフィックをセカンダリにリダイレクトします。
フェイルバック
Sitecoreがフェイルオーバープロセスを完了し、災害の原因が解決された後、顧客とManaged Cloud Operationsチームはプライマリリージョン環境に戻るタイミングを合意します。フェイルバック後、プライマリ環境は障害前の状態から再開され、SQL Serverデータはセカンダリージョンから複製されます。