Monitoring Managed Cloud Standard
このページの翻訳はAIによって自動的に行われました。可能な限り正確な翻訳を心掛けていますが、原文と異なる表現や解釈が含まれる場合があります。正確で公式な情報については、必ず英語の原文をご参照ください。
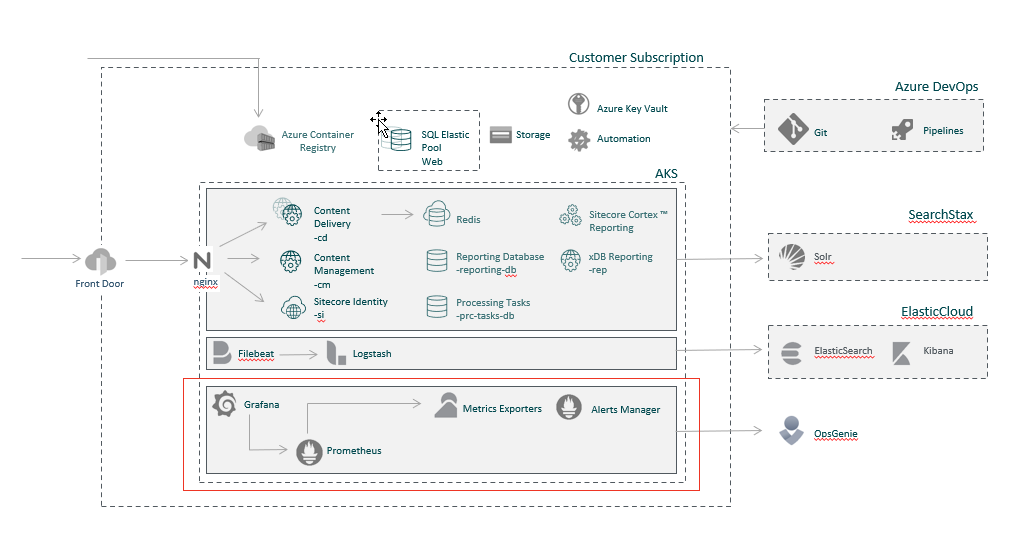
内蔵のモニタリングサービスを利用すれば、Managed Cloudソリューションのパフォーマンスと可用性を常に把握できます:
- メトリクスエクスポーター - サービスやインフラから既存のPrometheusサーバーへメトリクスをエクスポートするのに役立つライブラリ。
- Prometheus - サービスからメトリクスをスクレイピングし、データを集約・保存し、Grafanaのような他のサービスがこれらのメトリクスを収集できるようにします。
- グラファナ - プロメテウスから指標を集め、それを可視化します。
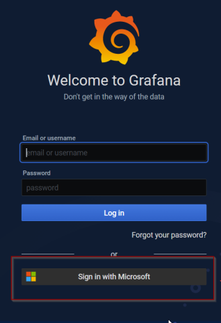
グラファナでの認証
GrafanaはActive Directory Azure統合されており、Basic Authenticationは無効です。したがって、Sign in with Microsoft認証オプションを選択し、Microsoftの職場アカウントを使う必要があります。
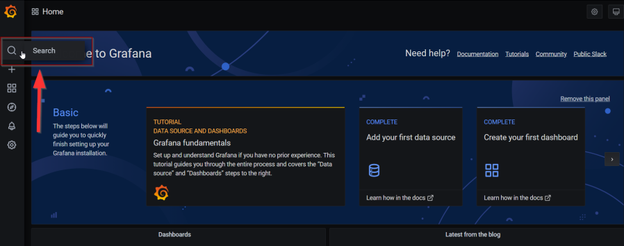
ダッシュボード
ダッシュボード名で検索したり、1つ(または複数)タグで絞り込んだり、星付きステータスで絞り込んだりできます。ダッシュボードの上部ナビゲーションエリアにあるダッシュボードピッカーからアクセスできます。ショートカットFを使ってダッシュボード検索を開くこともできます。
以下のデフォルトダッシュボードが利用可能です:
ダッシュボード
概要
コンテナ概要
すべてのコンテナとその名前空間およびポッドを一覧表示します。各コンテナの状態と、健康/不健康および停止中のコンテナの総数を提供します。
ホストディスク概要(Linuxのみ)
ノードのファイルシステムやディスクのI/O指標、例えば読み書き時間、ファイルシステムの空き容量などを公開します。
ホストディスク概要(Windowsのみ)
ファイルシステムの利用可能な空き容量を示します。
入口概要
各SitecoreロールとGrafanaのIngressメトリクスを提供します。
Kubernetesクラスター
Kubernetesクラスターの概要を提供します。
Kubernetesポッド概要
システムを含むすべての名前空間に対して、ポッドごとのメモリおよびCPUリクエスト、制限、利用率を公開します。ライブログを提供します。
Linuxノード概要
各Linuxノードのメモリ/CPU/ディスク利用率に関する詳細な情報を提供します。
MsSQL エラスティックプール
MsSQLエラスティックプール利用に関する詳細な情報を提供します。
Redis サーバー概要
一般的なRedisの指標を公開します。ネイティブのRedisの「INFO」コマンドに似ています。
Windows ノード概要
各Windowsノードのメモリ/CPU/ディスク利用率に関する詳細な情報を提供します。
警報
アラートは、Managed Cloudソリューションに問題が見つかった際に積極的に通知します。これにより、システムのユーザーが気づく前に問題を特定し対処することが可能です。以下の表は利用可能なアラートの一覧です:
概要
状態
リソース
以上
ノード統計量
メモリパーセンテージは>95%です
ノードメモリ使用率は95%を超えています。
Kubernetesノード
10分
CPUパーセンテージは>95%です
CPU負荷率は95%以上です。
Kubernetesノード
10分
インフラ
ポッドは30mで準備できていません
ポッドの状態!= 準備完了
Kubernetes pod
30分
クベレットが倒れました
kubeletの仕事は最後の15分間は止まっている。
Kubernetes job
15分
ポッドが頻繁に再起動しています
ポッドは少なくとも5分ごとに1回再起動されます。
Kubernetes pod
1時間
展開生成のミスマッチ
展開は失敗しましたが、後退はしていません。
Kubernetesのデプロイメント
15分
デプロイレプリカの不一致
展開は1時間以上、期待されたレプリカ数に合致していません。
Kubernetesのデプロイメント
1時間
DaemonSetポッドが準備できていません
すべての希望のポッドがスケジュールされて準備が整っているわけではありません。
Kubernetes daemonset
15分
DaemonSetポッドのスケジュールがありません
希望するポッドがすべてスケジュールされているわけではありません。
Kubernetes daemonset
10分
DaemonSetポッドの誤スケッチ
デーモンセットのポッドが本来走ってはいけない場所で走っている。
Kubernetes daemonset
1時間
CPUのスロットリングが大きいです
ポッドのCPUスロットリング率は25%以上です。
Kubernetes pod
15分
警告事象が発生した
名前空間ではタイプ Warning のイベントが1つ以上発生しました。
Kubernetes名前空間
1時間
ノードはまだ準備ができていません
ノードはまだ準備できていません。
Kubernetesノード
1時間
Kubernetesバージョンの不一致
Kubernetesコンポーネントにはさまざまな意味的バージョンが動作しています。
Kubernetes
1時間
Kubernetes APIサーバークライアントがエラーが発生しています
Kubernetes APIサーバーでエラーが複数あります。
Kubernetes
5分
ノードのポッド容量が限界です
ノードポッドの容量は95%以上です。
Kubernetesノード
15分
ディスクスペースは>90%で使用されます
ノードディスク空間は90%以上を占めています。
Kubernetesノード
1時間
Sitecoreの役割
HTTPリクエストは5xx >10
5xxのHTTP応答は10以上です。
nginx_ingress_controller
10分
平均ページ応答時間>1秒
平均応答時間は1秒以上です。
nginx_ingress_controller
30分
平均ページ応答時間>30秒
平均応答時間は30秒以上です。
nginx_ingress_controller
5分
可用性テストが行われています /sitecore/service/keepalive.aspx
/sitecore/service/keepalive.aspxの利用可能性テストは失敗しました。
Sitecoreポッド
5分
Redis キャッシュ
接続されたクライアントの割合は>80%です。
接続された顧客数は redis_config_maxclientsに比べて80%以上です。
Redis キャッシュ
30分
サーバー負荷は>95%です
過去30分間でRedisのプロセッサ負荷率は95%を超えています。
Redis キャッシュ
30分
MSSQLエラスティックプール
データベーススループットユニット(DTU)は>95%です。
平均スループット単位(DTU)は95%以上です。
30分
ストレージの割合は>75%です
平均ストレージ率は75%以上です。
5分
CPUは>95%です。
平均CPU使用率は95%以上です。
5分
SQL データベースのデッドロック
データベースがデッドロック中です。
データ輸入率は>95%です。
平均的なデータ輸入率は95%以上です。
5分
ログのIOパーセンテージは>95%です
平均的なLog IOパーセンテージは95%以上です。
5分
労働者の割合は>95%です
最大労働者の割合は95%を超えています。
5分
DB層でサポートされる同時セッション数は>95%です
DBティアでサポートされる最大同時セッション数は95%以上です。
5分
失敗したデータベース接続数>5
データベースでは過去5分間で5回の接続障害が発生しました。
5分
平均メモリ内OLTPストレージ>95%
平均的なインメモリOLTPストレージは95%以上です。
30分