処理と集約
このページの翻訳はAIによって自動的に行われました。可能な限り正確な翻訳を心掛けていますが、原文と異なる表現や解釈が含まれる場合があります。正確で公式な情報については、必ず英語の原文をご参照ください。
Content Delivery(CD)の役割は、体験データを収集 し、Sitecore Experience Database(xDB)に保存され、分析 やレポーティング 、マーケティングオートメーションで利用するためにほぼリアルタイムで処理されます。
ライブ集約
xDBは、提出されたデータやオンデマンドでデータを処理します。処理は収集されたデータを継続的に集約し、Experience Analyticsや外部のビジネスインテリジェンスツールを通じて実用的な洞察やレポート作成に利用できるようにします。
xConnect Collectionは、内部および外部の信頼できるシステムが接続し、連絡先に関する収集や更新されたデータに反応できる単一のエンドポイントを公開します。例えば、SitecoreソリューションがGDPRまたはプライバシー準拠であることを保証するために、システムは「 忘れる権利」操作を実行し、xConnect内の任意のプラグインがこれに応じて周囲のシステムに連絡を送ることができます。
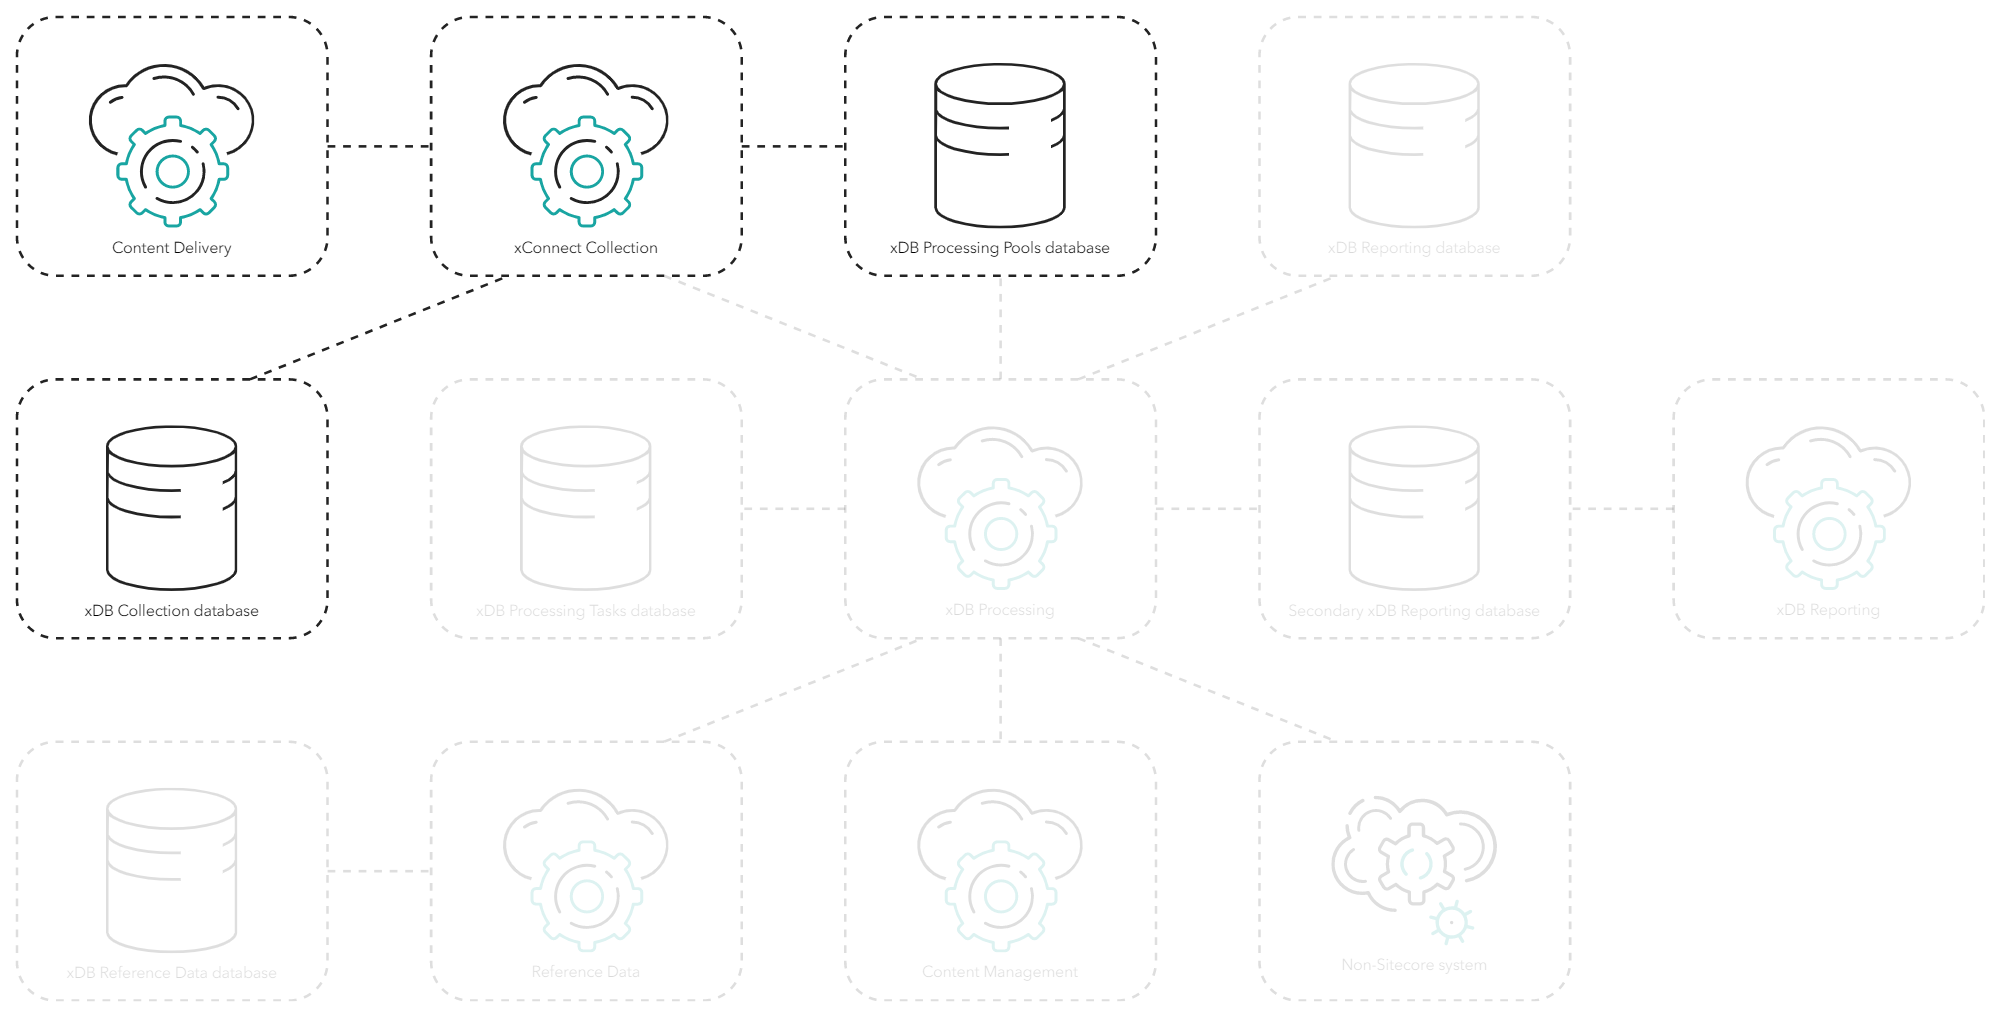
プラグインの概念は、収集中のデータを集約するためにも使われます。これをライブ集約と呼びます。
例えば、Content Deliveryセッションが終了すると、xConnect Collectionロールにインタラクションを提出し、xConnectのライブアグリゲーションプラグインが反応します。プラグインはxDB Processing Poolsデータベースにレコードを保存し、新しいインタラクションの処理方法についてxDB Processingアプリケーションに情報を中継します。
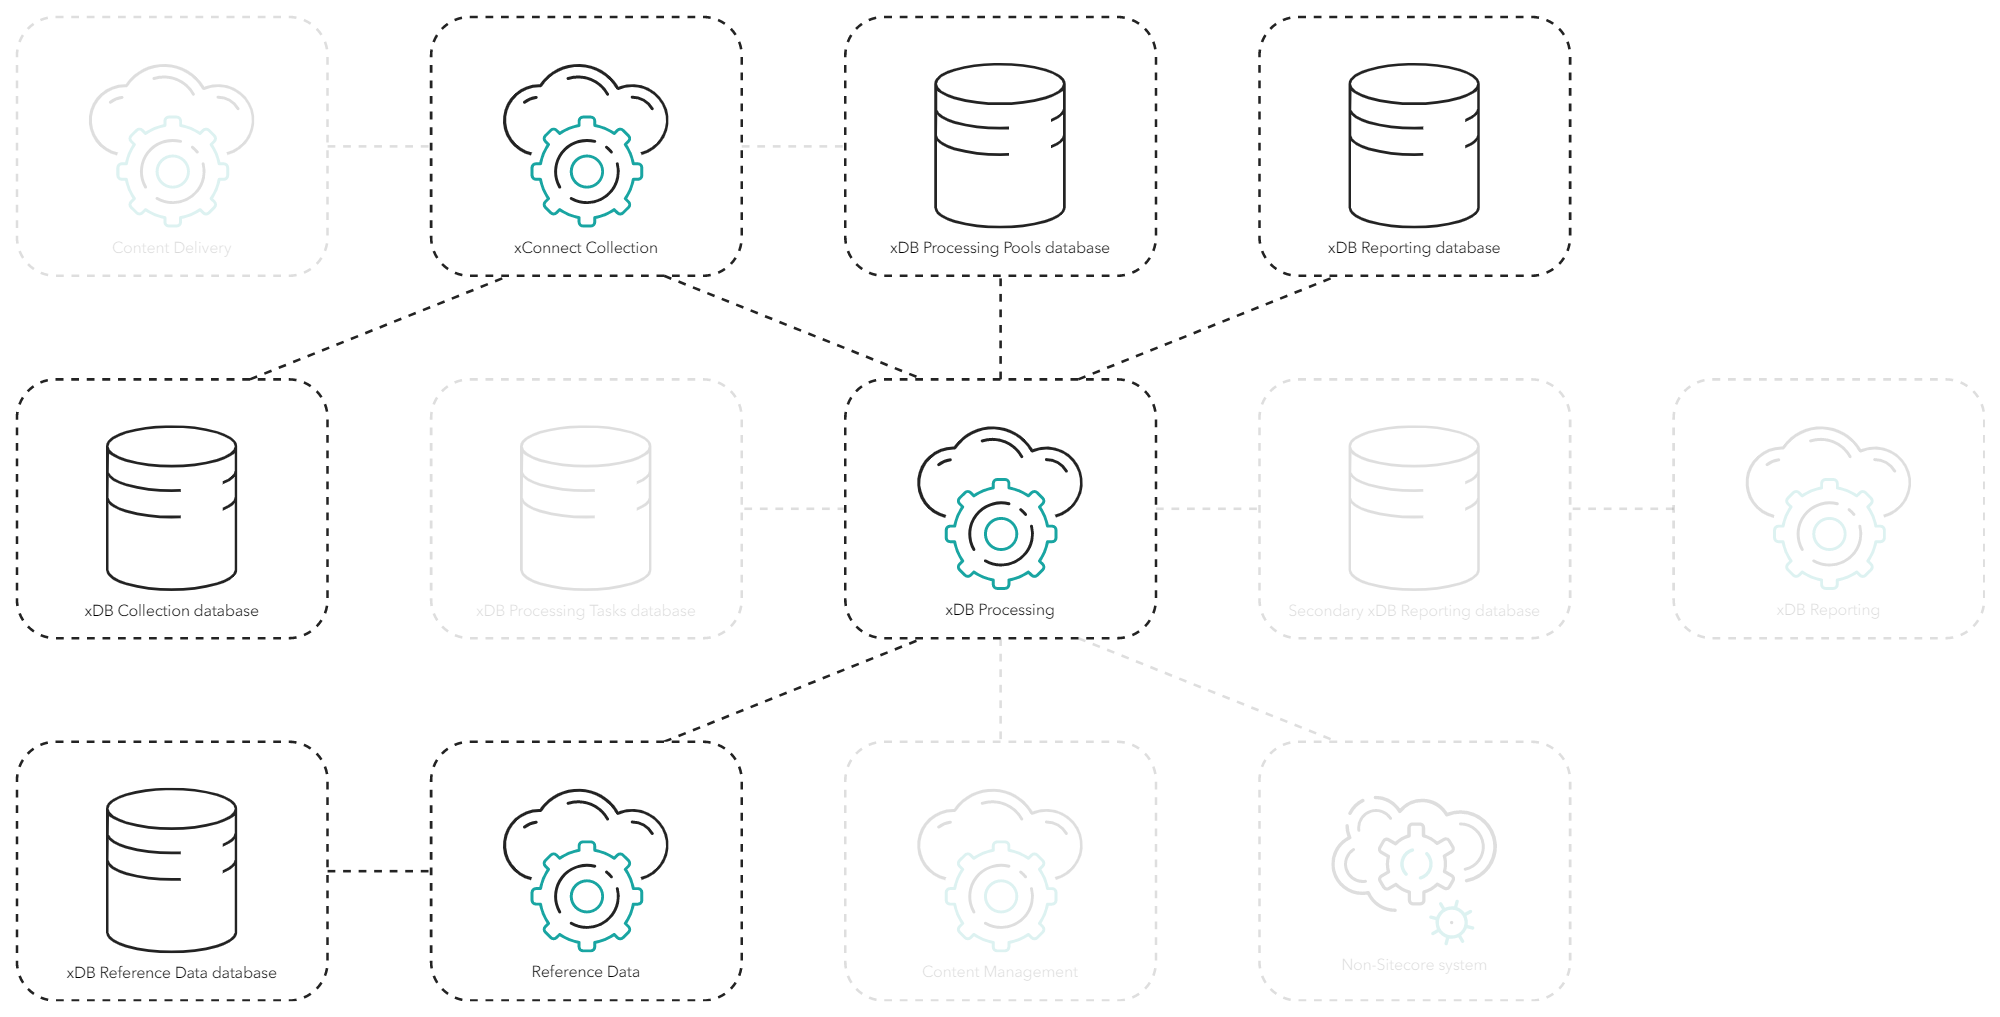
xDB Processingは継続的にxDB Processing Poolsデータベースをポーリングし、最近追加された集約タスクを抽出して集約プロセスを開始します。
処理中、xDB ProcessingはxConnect Collectionの役割から新しいインタラクションや、集計に必要な追加データを他のソース(例えばReference Dataサービス)から引き出します。
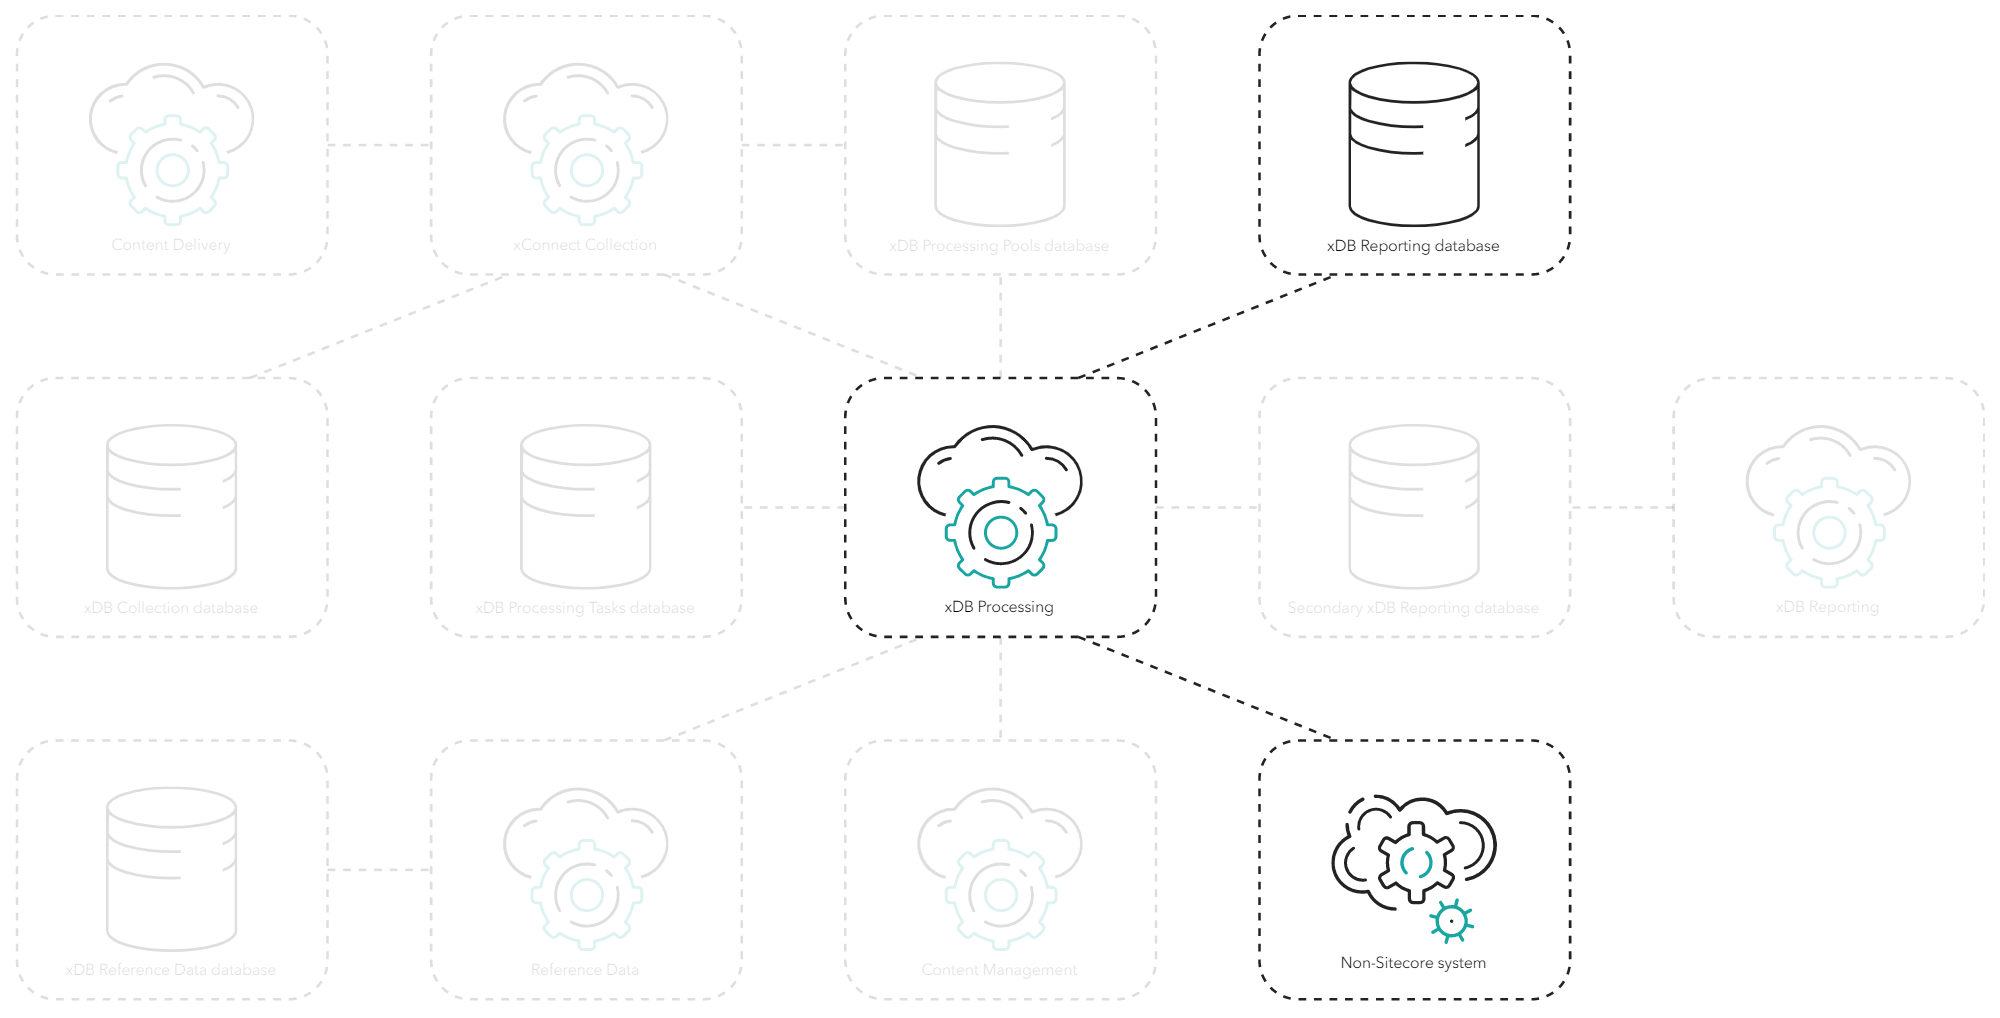
最後に、集約が完了すると、その結果得られたデータはxDB Reportingデータベースに保存されます。
二次報告データベース
新しいSitecoreバージョンを展開した後、または新しいレポート次元やデータセットでソリューションを拡張した場合は、xDB内のすべてのやり取りを再処理しなければなりません。このプロセスを 「履歴集約」と呼びます。
履歴集約を有効にするには、追加の二次的なxDBレポートデータベースを設定する必要があります。
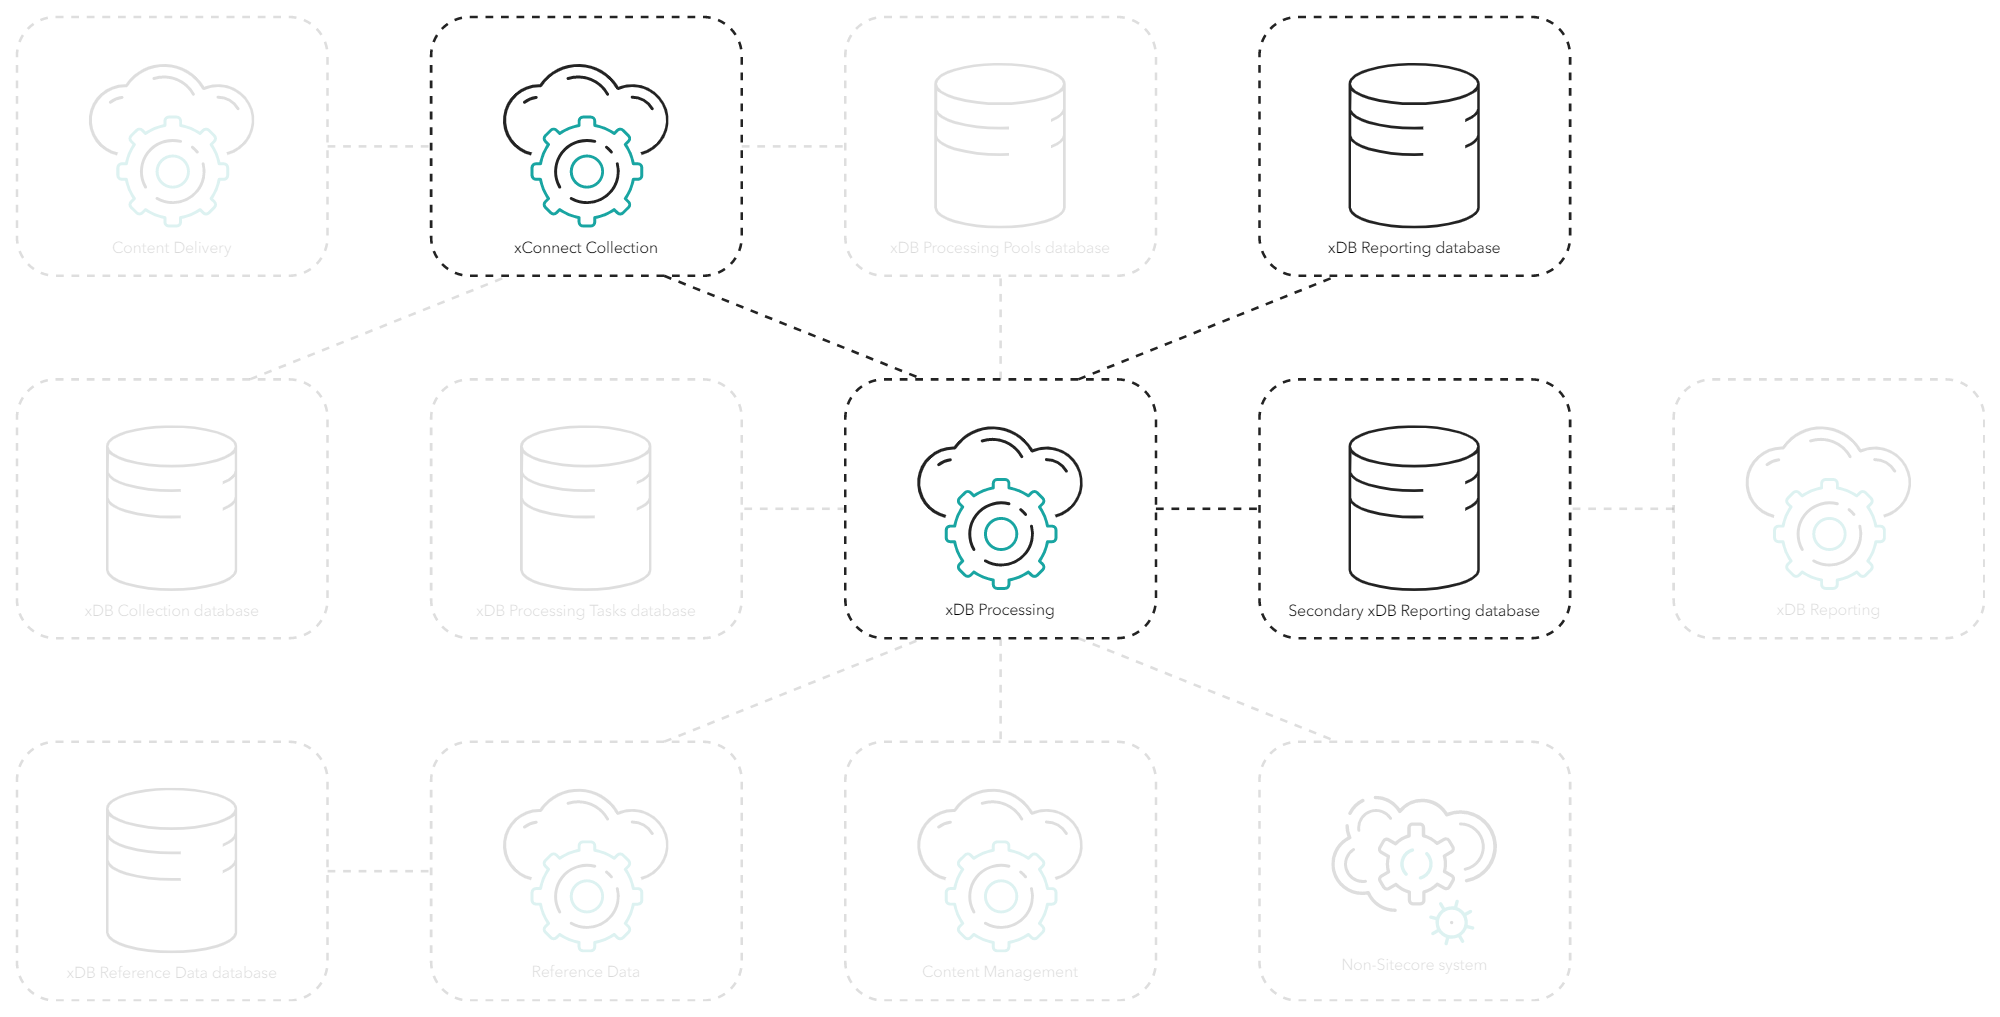
セカンダリのxDBレポートデータベースをxDB処理ロールに接続すると、プライマリとセカンダリの両方のxDBレポートデータベースが すべてのライブ集約 データを保存します。
!注過去の再集計を実行する予定がある場合を除き、二次的なxDB報告データベースを追加してはいけません。これは、システムがプライマリとセカンダリのxDBレポートの両方に書き込みをしなければならず、システム全体の負荷が増加するためです。
歴史的集積
管理者はSitecore管理インターフェースを通じて過去の再集約プロセスを開始できます。Content Management (CM)ロールはxDB処理ロールの処理操作をトリガーします。
これにより、まず二次的なxDB報告データベース内のすべてのデータを消去し、xDB処理タスクデータベースに過去の再集約タスクが作成されます。その後、xDB処理ロールはデータを抽出し、xDBコレクションデータベース内の全インタラクションセットの列挙子を取得します。
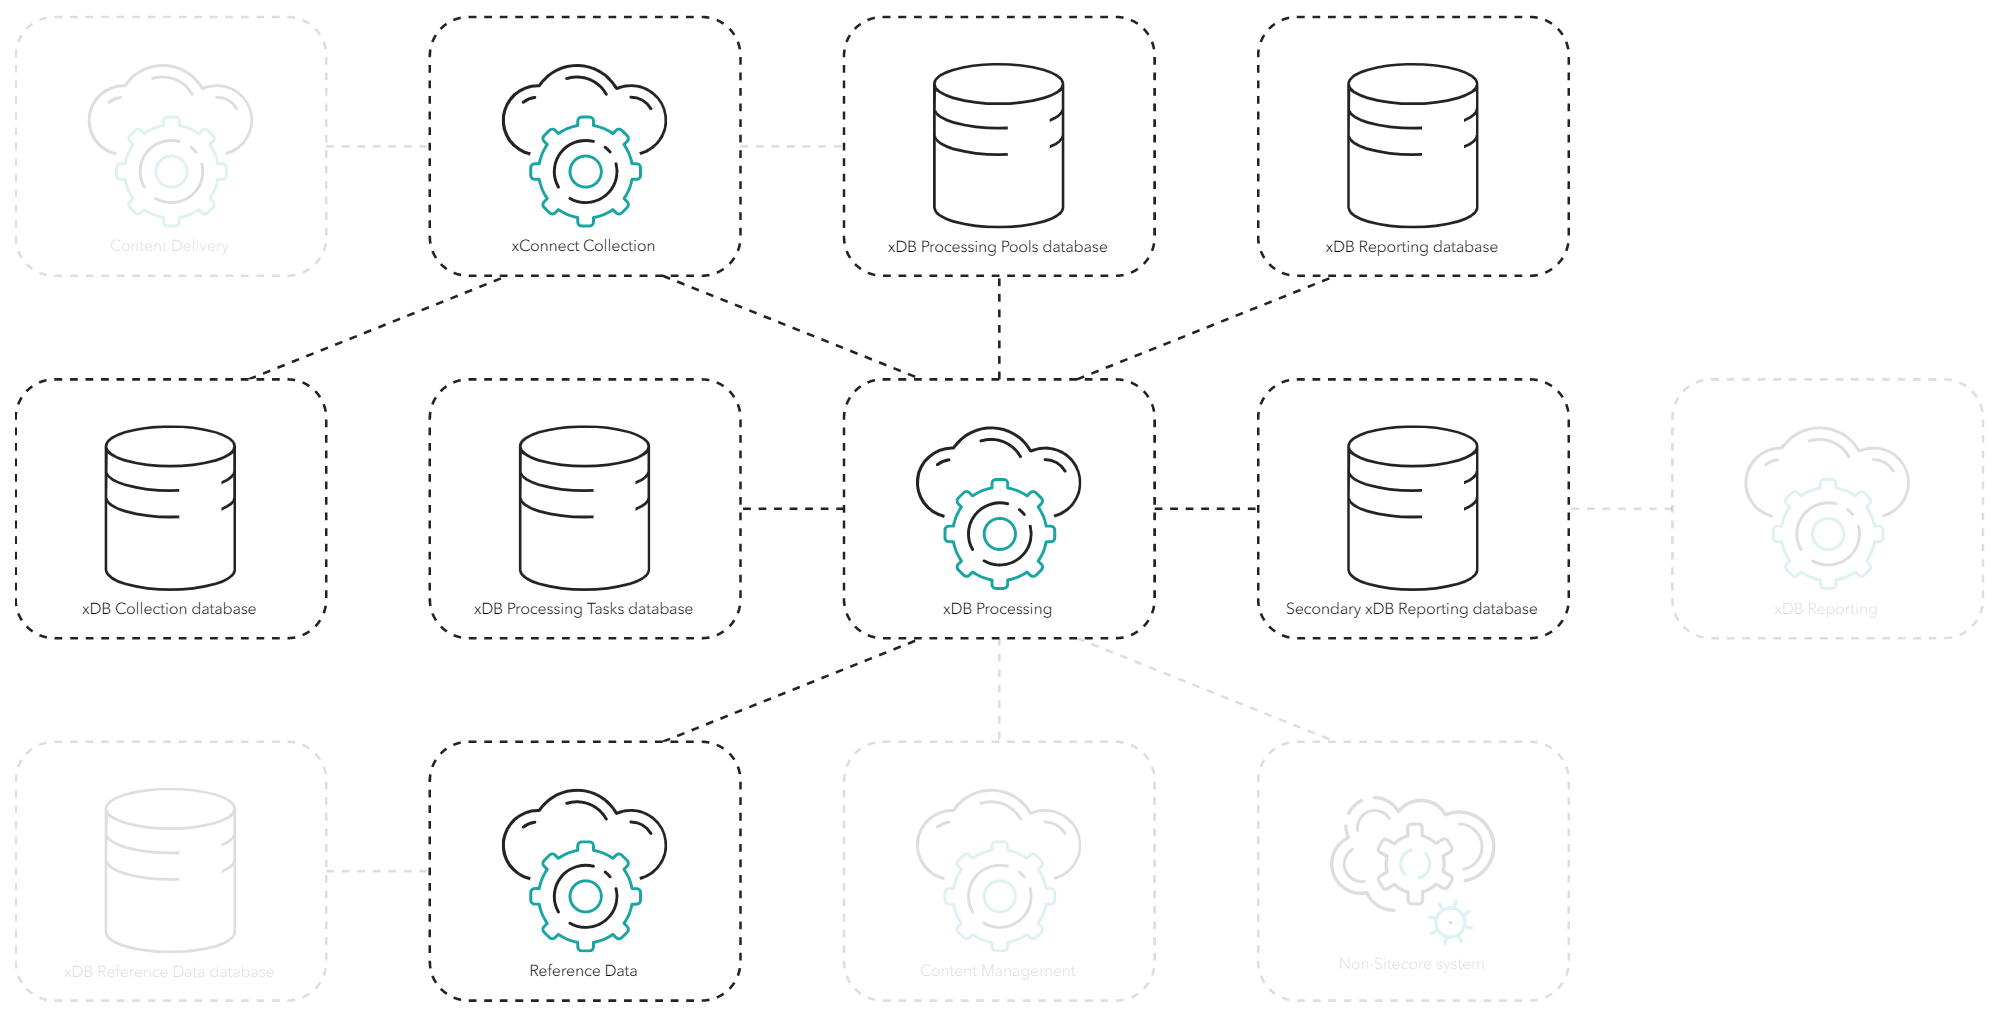
単一のインタラクションの集約が失敗した場合、それはxDB処理プールデータベースに追加され、過去の再集約プロセスの最後に再試行されます。
xConnect Collectionロールを通じて新しいインタラクションが入ってきた場合、ライブアグリゲーションプロセスはそれらをプライマリおよびセカンダリの両方のデータベースに書き込みます。これにより、過去のアグリゲーションプロセス中にxConnectに提出された新しいインタラクションが失われないことを保証します。
!注Sitecore Experience Databaseで過去のすべてのやり取りを処理するのは非常にリソースを消費します。システムの負荷を避けるために、xDB処理の役割を水平にスケールさせ、集約タスクを複数のサーバーやスレッドに分散させることができます。
開始するxDB処理ロールは、xDB処理タスクデータベース内のデータセットを複数の部分に分割し、各xDB処理ロールの処理ワーカーまたはスレッドに割り当てます。
各処理ワーカーはxConnect Collectionの役割からインタラクションデータを取得し、集約に必要な追加データを他のソース(例えば参照データサービス)から取得します。
集約が完了すると、セカンダリのxDBレポートデータベースに新たに集約されたデータが格納されます。しかし、プライマリxDBレポートデータベースは常にレポート、インサイト、分析アプリケーションを担当するため、システム管理者は新しいデータが稼働していることを確認するためにセカンダリとプライマリのxDBレポートデータベースを切り替える必要があります。システム管理者は通常、接続文字列を更新することで手動でデータベースを切り替えることができます。
分散処理
xDB Processingの役割が扱う最後の処理タイプは分散処理です。
分散処理は、システムがxDBのデータ処理タスクをスケジュール化し、他のデータベースに分散させることを可能にします。例えば、Path Analyzerは分散処理操作を用いてインタラクションを処理し、集約されたトラフィックマップを保存します。
例えば、xDB Processing APIを使って分散処理処理をキューにし、xDB処理ロールで動作するスケジュールタスクを通じて行えます。
分散処理タスクがトリガーされると、xDB処理タスクデータベースはタスクレコードを作成します。xDB処理ロールは、xDBコレクションデータベース内のインタラクションや連絡先など、目的のエンティティセットの列挙子を取得するためにデータ抽出を行います。時間範囲に基づいてデータセットを制限できます。データセットはxDB処理タスクデータベース内でパート(カーソル)に分割されます。各xDB処理ロールごとに1つのカーソルがあります。
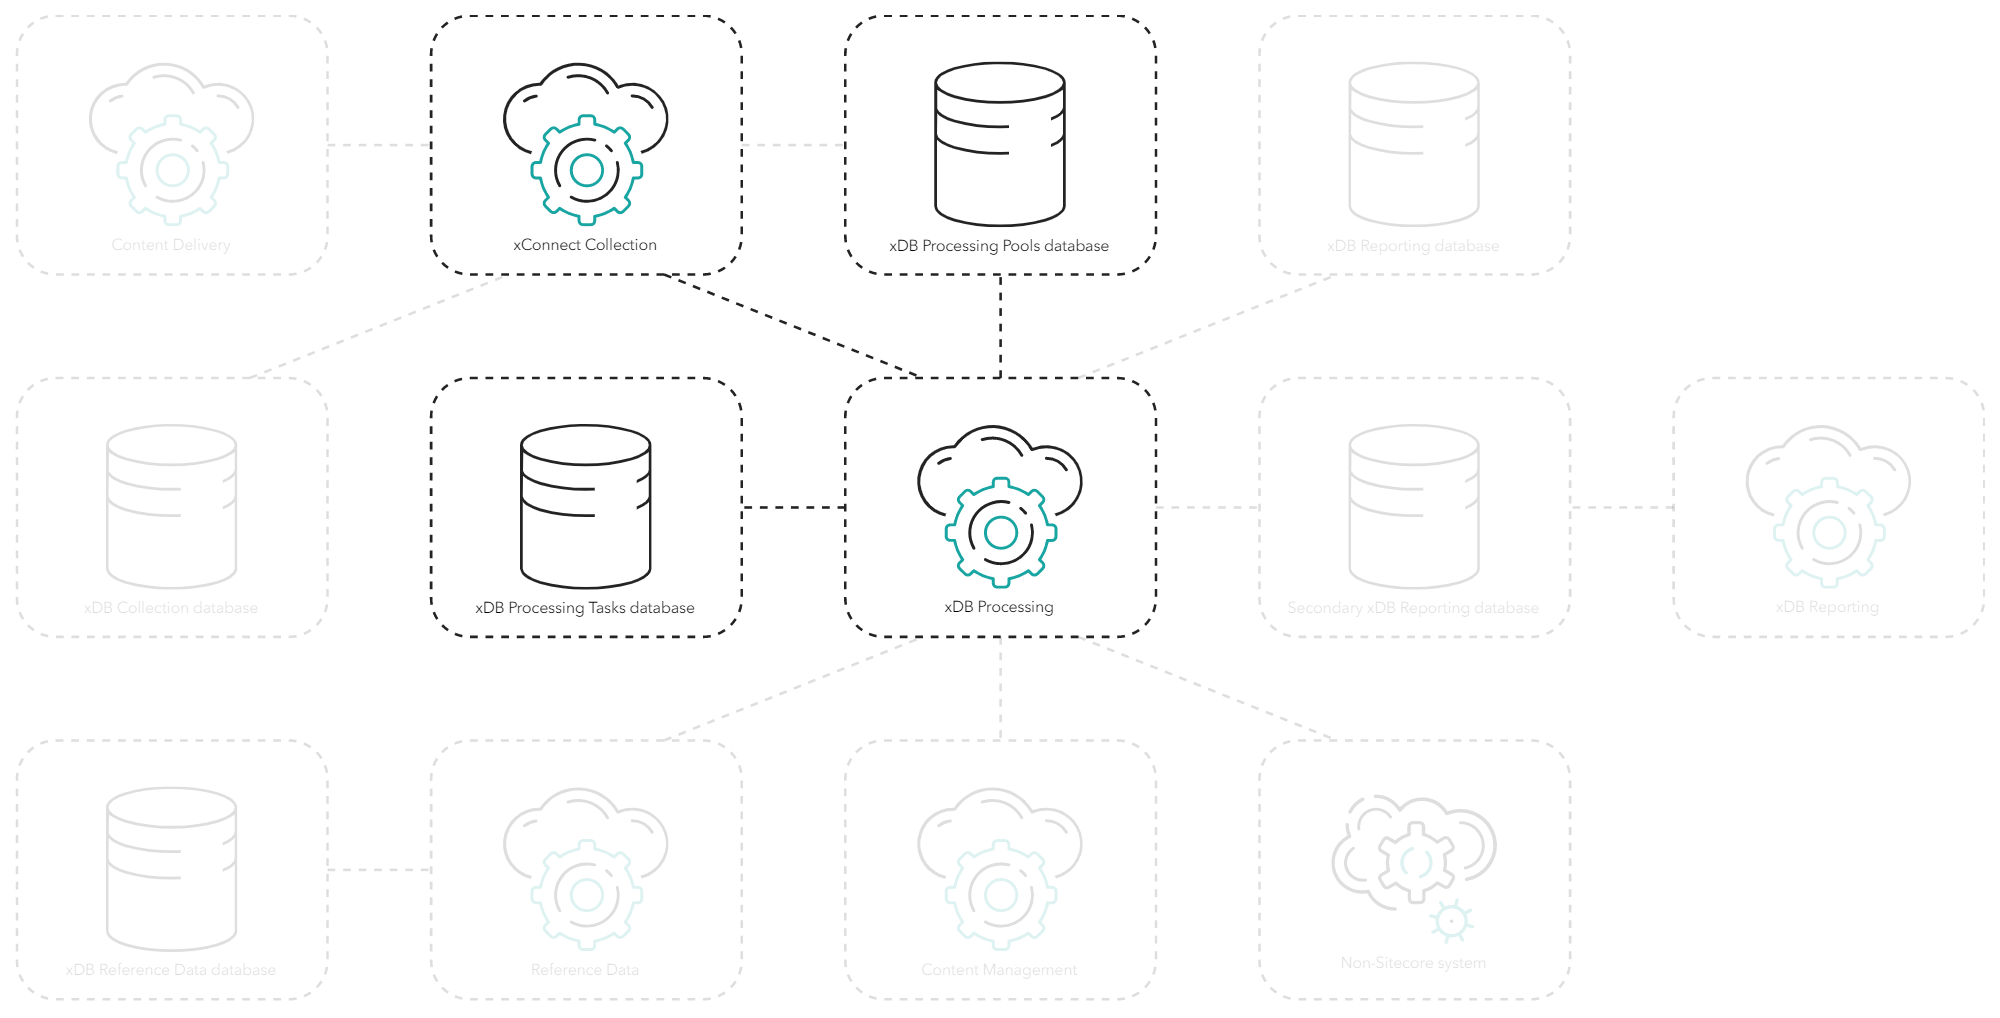
カスタムロジックはすべてのxDB処理ロールで動作し、エンティティを処理します。処理中はカスタム処理ロジックが処理済みデータを他のシステムで保存または処理するために継続的に送信します。例えば、Path Analyzer用の特定の集約データはxDB Reporting database内の別々のテーブルに格納されます。
プライバシーとセキュリティ
処理および集約データフロー上の各役割のプライバシーおよびセキュリティに関する考慮事項については、アーキテクチャおよびロールドキュメント を参照してください。